BCQ-Binary Coded Quantization
BCQ(Binary-Coded Quantization)는 하나의 가중치를 여러 이진 부호와 스케일의 합으로 표현하는 양자화 방식이다. 저장할 때는 이진 코드를 사용하고, 계산할 때는 그 코드가 지정하는 덧셈·뺄셈 패턴을 이용한다.
이 글에서는 BCQ의 공통 원리를 먼저 설명한 뒤, ShiftAddLLM, AnyBCQ, LUT-GEMM, FIGLUT 네 논문을 연결해서 살펴본다. 네 연구가 공유하는 것은 가중치 표현이지만, 실제로 해결하려는 병목과 구현하는 시스템은 서로 다르다.
1. 왜 BCQ가 필요했는가?
1.1. 가중치를 작게 저장하는 것과 빠르게 계산하는 것은 다르다
LLM의 선형 계층은 기본적으로 다음 계산을 수행한다.
\[Y=WX.\]가중치 $W$를 FP16 대신 저비트 형식으로 저장하면 모델 크기와 가중치를 읽는 데 필요한 메모리 트래픽을 줄일 수 있다. 특히 작은 배치의 autoregressive decoding에서는 가중치를 반복해서 읽는 비용이 중요하므로, weight-only quantization이 유용하다.
하지만 가중치 저장량이 줄었다고 곱셈 비용까지 같은 비율로 줄어드는 것은 아니다. 저비트 가중치를 실행에 사용할 수 있는 수치로 복원한 뒤, 고정밀 activation과 곱하는 과정이 필요할 수 있기 때문이다.
예를 들어 W4A16은 가중치를 4비트로 저장하면서 activation은 FP16으로 유지하는 방식이다. Activation까지 낮은 비트로 양자화하는 부담을 줄일 수 있지만, 하드웨어가 해당 혼합 정밀도 계산을 직접 지원하지 않으면 unpacking과 dequantization이 계산 경로에 들어간다. 이 복원은 커널 내부에서 타일 단위로 융합해서 수행할 수도 있으므로, 반드시 전체 가중치 행렬을 FP16으로 다시 저장한다는 의미는 아니다.
따라서 질문은 두 가지로 나뉜다.
- 원래 가중치를 적은 비트로 얼마나 정확하게 표현할 수 있는가?
- 그 표현을 풀어헤치지 않고도 효율적으로 계산할 수 있는가?
BCQ는 이 두 문제를 함께 다룰 수 있는 표현을 제공한다.
1.2. 가중치를 ‘스케일 × 부호’의 합으로 바꾸기
하나의 가중치를 다음과 같이 근사한다고 하자.
\[\hat w=\alpha_1b_1+\alpha_2b_2+\cdots+\alpha_qb_q, \qquad b_i\in\{-1,+1\}.\]각 $b_i$는 두 값 중 하나이므로 1비트로 저장할 수 있다. 실제 비트는 0과 1이지만, 계산할 때는 이를 $-1$과 $+1$로 해석한다. 스케일 $\alpha_i$는 보통 여러 가중치가 공유한다.
이 표현의 중요한 점은 $b_ix$가 일반적인 곱셈이 아니라 $x$를 더할지 뺄지 선택하는 연산이라는 것이다.
\[\sum_j\hat w_jx_j =\sum_i\alpha_i\left(\sum_jb_{ji}x_j\right).\]안쪽 합은 activation들의 부호 있는 합이다. 같은 activation 묶음에서 가능한 합을 미리 만들어 두면, 여러 가중치가 그 결과를 조회해서 재사용할 수 있다. 이것이 BCQ와 LUT 기반 연산이 연결되는 지점이다.
다만 BCQ 자체가 모든 곱셈을 없애는 것은 아니다. 위 식에도 스케일 $\alpha_i$를 곱하는 연산이 남아 있다. 이 스케일까지 어떻게 처리할지는 구현이나 논문에 따라 달라진다.
1.3. 균일하지 않은 양자화 간격도 표현할 수 있다
2비트 BCQ에서 스케일을 $\alpha_1=2$, $\alpha_2=0.5$로 정하면 표현 가능한 값은 다음과 같다.
| $b_1$ | $b_2$ | $\hat w$ |
|---|---|---|
| $-1$ | $-1$ | $-2.5$ |
| $-1$ | $+1$ | $-1.5$ |
| $+1$ | $-1$ | $1.5$ |
| $+1$ | $+1$ | $2.5$ |
인접한 값 사이의 간격은 $1,3,1$이다. 일정한 간격만 사용하는 uniform quantization과 달리, 스케일 선택에 따라 비균일한 값을 만들 수 있다.
그렇다고 $2^q$개의 값을 모두 독립적으로 선택할 수 있는 것은 아니다. 값들은 $q$개 스케일의 부호 있는 합이라는 제약을 받는다. 서로 다른 코드가 같은 값을 만들 수도 있고, 스케일에 따라 정확한 0이 표현되지 않을 수도 있다. BCQ의 유연성은 임의의 codebook보다는 제한적이지만, 그 구조 덕분에 계산을 규칙적으로 바꿀 수 있다.
2. BCQ의 알고리즘과 구현 방법
2.1. 기본 표현과 세 가지 크기 구분
길이가 $g$인 가중치 그룹 $w\in\mathbb{R}^g$를 생각하자. 대칭 BCQ의 기본 표현은 다음과 같다.
\[\hat w=B\alpha, \qquad B\in\{-1,+1\}^{g\times q}, \qquad \alpha\in\mathbb{R}^{q}.\]$B$의 한 열은 해당 그룹 전체에 대한 하나의 bit-plane이다. 각 가중치는 $q$개의 부호를 갖고, 그룹은 $q$개의 스케일을 공유한다. 필요하면 offset $z$를 추가해 $\hat w=B\alpha+z\mathbf1$로 확장할 수 있다.
이후 구현을 읽을 때는 다음 세 값을 구분해야 한다.
| 기호 | 의미 | 커졌을 때의 주요 변화 |
|---|---|---|
| $q$ | 가중치 하나의 이진 코드 비트 수 | 표현력과 저장량이 늘고, 처리할 bit-plane도 증가 |
| $g$ | 스케일을 공유하는 가중치 그룹의 길이 | 스케일 저장 부담은 줄지만 세밀한 분포 적응은 어려워질 수 있음 |
| $\mu$ | LUT 하나가 처리하는 activation 부분 벡터의 길이 | 한 번에 더 긴 합을 조회하지만 가능한 패턴이 $2^\mu$로 증가 |
3비트 BCQ라고 해서 LUT에 8개 항목만 필요한 것은 아니다. LUT 크기를 결정하는 것은 $q$가 아니라 $\mu$다.
2.2. 첫 번째 방법: 잔차를 순서대로 양자화하기
가장 간단한 초기화는 greedy residual quantization이다. 먼저 1비트 근사를 생각해 보자.
\[\min_{\alpha,b}\|w-\alpha b\|_2^2, \qquad b_j\in\{-1,+1\}.\]스케일을 음수가 아닌 값으로 두면, 다음 선택을 사용할 수 있다.
\[b_j=\operatorname{sign}(w_j), \qquad \alpha=\frac{1}{g}\sum_j|w_j|.\]0의 부호는 구현에서 $+1$ 등으로 일관되게 정하면 된다. BCQ의 부호 집합에는 0이 없으므로, 일반적인 sign 함수가 0을 반환하는 경우를 그대로 사용하면 안 된다.
여러 비트로 확장할 때는 현재까지 표현하지 못한 잔차를 다음 bit-plane이 담당한다.
\[\begin{aligned} r^{(0)}&=w,\\ b_i&=\operatorname{sign}(r^{(i-1)}),\\ \alpha_i&=\frac{1}{g}\sum_j|r_j^{(i-1)}|,\\ r^{(i)}&=r^{(i-1)}-\alpha_i b_i. \end{aligned}\]예를 들어 $w=[2.4,-1.2,0.6,-3.0]^T$라면 다음과 같다.
| 단계 | 새 스케일 | 새 부호 벡터 | 누적 근사 $\hat w$ | 잔차 제곱합 |
|---|---|---|---|---|
| 1비트 | $1.8$ | $[+1,-1,+1,-1]$ | $[1.8,-1.8,1.8,-1.8]$ | $3.60$ |
| 2비트 | $0.9$ | $[+1,+1,-1,-1]$ | $[2.7,-0.9,0.9,-2.7]$ | $0.36$ |
| 3비트 | $0.3$ | $[-1,-1,-1,-1]$ | $[2.4,-1.2,0.6,-3.0]$ | $0$ |
이 예에서는 3비트로 정확하게 복원되지만, 일반적인 가중치 그룹에서 정확한 복원이 보장되는 것은 아니다. Greedy 방식은 빠르고 직관적인 초기화를 제공하는 대신, 앞에서 정한 부호와 스케일을 뒤의 선택에 맞춰 충분히 재조정하지 못한다.
2.3. 두 번째 방법: 부호와 스케일을 번갈아 최적화하기
더 정밀하게 맞추려면 다음 문제를 풀어야 한다.
\[\min_{B,\alpha}\|w-B\alpha\|_2^2.\]$B$는 이산 변수이고 $\alpha$는 연속 변수이므로 동시에 최적화하기 어렵다. 보통 한쪽을 고정하고 다른 쪽을 갱신하는 방식으로 접근한다.
① 부호 $B$를 고정하고 스케일을 갱신한다.
이때는 최소제곱 문제다.
\[\alpha^*=B^\dagger w.\]$B^\dagger$는 pseudoinverse다. $B$의 열들이 선형 독립이면 $(B^TB)^{-1}B^Tw$로 쓸 수 있지만, 실제 구현에서는 역행렬을 직접 계산하기보다 lstsq 같은 수치적으로 안정적인 해법을 사용하는 편이 좋다.
② 스케일 $\alpha$를 고정하고 각 가중치의 부호 코드를 갱신한다.
가능한 부호 벡터 $c\in{-1,+1}^q$마다 $c^T\alpha$를 계산한다. 그다음 각 $w_j$와 가장 가까운 값을 만드는 코드를 선택한다.
\[B_{j,:} =\arg\min_{c\in\{-1,+1\}^q} |w_j-c^T\alpha|^2.\]낮은 비트 수에서는 $2^q$개 후보를 직접 비교할 수 있다. 값을 정렬해 가까운 구간을 이진 탐색하는 구현도 가능하다. 여기서의 이진 탐색은 수치 후보를 찾는 절차이며, 단순히 원래 가중치의 양수·음수를 검사한다는 뜻이 아니다.
기본 알고리즘은 다음과 같이 요약할 수 있다.
1
2
3
4
5
6
7
8
입력: 가중치 그룹 w, 비트 수 q
1. 잔차 양자화로 B와 alpha를 초기화한다.
2. 반복한다.
   a. B를 고정하고 최소제곱으로 alpha를 구한다.
   b. 모든 q비트 부호 코드의 값을 계산한다.
   c. 각 w[j]를 가장 가까운 값의 코드에 배정한다.
3. 최종 B에 대해 alpha를 다시 맞춘다.
4. B의 -1/+1을 0/1로 바꾸어 packing하고 alpha와 함께 저장한다.
각 부분 문제를 정확하게 풀면 해당 목적함수는 증가하지 않는다. 그러나 전체 문제가 비볼록이므로 전역 최적해를 보장하지는 않는다. 또한 activation을 고려하는 목적함수나 코드 공유 제약을 추가하면 갱신 방법도 그 제약에 맞게 달라져야 한다.
2.4. 가중치 오차보다 출력 오차가 중요할 수 있다
위 알고리즘은 가중치 자체를 잘 복원하는 방법이다. 하지만 신경망에서 중요한 것은 그 가중치를 사용한 계층 출력이다.
Calibration activation을 $X$, 양자화 오차를 $\Delta W=W-\hat W$라고 하면 출력 오차는 다음과 같다.
\[\|WX-\hat WX\|_F^2 =\|\Delta W X\|_F^2 =\operatorname{tr}(\Delta WXX^T\Delta W^T).\]같은 크기의 가중치 오차라도 어떤 입력 방향에 발생하느냐에 따라 출력에 미치는 영향이 다르다. 따라서 실용적인 LLM 양자화에서는 calibration 데이터를 사용해 출력 복원을 확인하고, 스케일을 조정하거나 오차를 보상하는 과정이 중요하다.
이 식은 activation-aware 최적화가 필요한 이유를 보여주는 공통 설명이다. 네 논문 모두가 이 식을 동일한 알고리즘으로 최적화한다는 뜻은 아니다.
2.5. LUT로 부호 있는 합을 재사용하기
Activation 벡터를 길이 $\mu$의 부분 벡터로 나누자. 각 부분 벡터에 대해 가능한 모든 부호 있는 합을 계산한다.
\[T[k] =\sum_{j=0}^{\mu-1}\bigl(2c_j(k)-1\bigr)x_j, \qquad 0\le k<2^\mu.\]$c_j(k)$는 정수 인덱스 $k$의 $j$번째 비트다. 가중치 bit-plane에서 해당 위치의 비트들을 모으면 LUT 인덱스가 되고, 조회 결과가 필요한 부분 내적이 된다.
예를 들어 $\mu=2$, $x=[3,5]$이고 표에서 비트를 $(c_0,c_1)$ 순서로 적으면 다음과 같다.
| $k$ | $(c_0,c_1)$ | 부호 있는 합 | $T[k]$ |
|---|---|---|---|
| 0 | $(0,0)$ | $-3-5$ | $-8$ |
| 1 | $(1,0)$ | $+3-5$ | $-2$ |
| 2 | $(0,1)$ | $-3+5$ | $2$ |
| 3 | $(1,1)$ | $+3+5$ | $8$ |
가중치 부호가 $[+1,-1]$이면 다시 $3-5$를 계산하는 대신 $T[1]$을 읽는다. 같은 activation을 사용하는 다른 출력 행도 이 표를 공유할 수 있다.
이때 두 종류의 lookup을 혼동하면 안 된다.
- 가중치 복원용 lookup: 코드에서 양자화된 가중치 값을 찾는다.
- BCQ 연산용 LUT: 코드에서 activation의 부분 내적을 찾는다.
후자는 가중치 값을 먼저 복원하지 않고 계산 결과를 직접 가져온다. 다만 activation이 달라지면 LUT도 다시 만들어야 한다. 모델을 배포할 때 한 번 생성해서 계속 쓰는 상수 테이블이 아니다.
그룹별 스케일을 사용하는 출력 행 $r$의 계산은 다음처럼 정리할 수 있다.
\[y_r =\sum_{\text{group }h} \left[ \sum_{i=1}^{q}\alpha_{r,h,i} \sum_{t\in h}T_t[k_{r,t,i}] +z_{r,h}\sum_{j\in h}x_j \right].\]여기서는 LUT 부분 벡터가 양자화 그룹 안에 정렬되어 있다고 가정한다. 스케일이 달라지는 그룹을 넘어 부분합을 먼저 합치면 안 된다. 그룹마다 해당 스케일을 적용한 뒤 결과를 합쳐야 한다.
2.6. 저장 형식과 LUT 크기를 함께 결정해야 한다
일반적인 BCQ 그룹에서 $qg$개의 부호 비트와 $q$개의 FP16 스케일을 저장한다면, offset을 제외한 가중치당 저장량은 다음과 같다.
\[q+\frac{16q}{g}\quad\text{bits/weight}.\]예를 들어 $q=3$, $g=128$이면 실제로는 $3.375$ bits/weight다. 정렬·패딩·추가 메타데이터까지 고려하면 더 늘어날 수 있다. Uniform 형식처럼 스케일을 더 적게 저장하는 특수한 경우는 별도로 계산해야 한다.
한편 LUT 항목 수는 $2^\mu$다. $\mu$가 커지면 조회 한 번으로 처리하는 부분 벡터는 길어지지만, 테이블 생성과 저장 비용이 급격히 증가한다.
입력이 길이 $n$인 벡터이고 출력 행이 $m$개라면, 효율적인 누적 방식으로 LUT를 생성할 때의 대략적인 연산량은 다음 형태다.
\[O\left(\frac{n}{\mu}2^\mu\right) +O\left(\frac{mnq}{\mu}\right).\]첫 항은 LUT 생성, 두 번째는 조회와 누적에 해당한다. 스케일 처리와 메모리 접근 비용은 생략한 식이다. 따라서 $q/\mu$만 보고 곧바로 실제 속도 향상을 계산할 수는 없다. 재사용할 출력 행 수, 메모리 구조, 병렬 실행량까지 함께 봐야 한다.
2.7. Uniform quantization도 확장 BCQ로 표현할 수 있다
일반적인 unsigned 정수 코드 $u$에 대해
\[\hat w=s(u-z_p), \qquad u=\sum_{i=0}^{q-1}2^ic_i\]라고 하자. $b_i=2c_i-1$을 대입하면
\[\hat w =\sum_{i=0}^{q-1}s2^{i-1}b_i +s\left(\frac{2^q-1}{2}-z_p\right)\]가 된다. 즉, 스케일에 정해진 비율을 주고 offset을 더하면 uniform quantization도 같은 계산 형태로 다룰 수 있다.
여기서 정수 zero-point $z_p$와 실수 offset은 서로 다른 값이다. Offset이 존재하면 출력 계산에도 입력 합을 이용한 보정 항이 필요하다. 이 확장은 LUT-GEMM이 BCQ 구조를 더 넓은 양자화 형식과 연결하는 데 중요한 역할을 한다.
2.8. 실제 숫자로 따라가기: 스케일 최적화 → 정밀도 확장 → LUT 연산
이번에는 스케일을 미리 정하지 않고, 원래 가중치로부터 부호와 스케일을 구하는 단계에서 출발한다. 먼저 2비트 BCQ를 만든 뒤, AnyBCQ처럼 기존 bit-plane을 유지하면서 3비트로 확장한다. 마지막에는 두 정밀도를 실제 activation과 계산하고 FP×FP 방식과 연산량을 비교한다.
설명을 위해 가중치 4개가 스케일을 공유하는 한 그룹을 사용하고, bias와 offset은 생략한다. 여기서 구하는 $y$는 선형 계층 출력이며, 이후 활성화 함수는 적용하지 않는다. 아래 계산은 코드 고정과 스케일 재최적화의 차이를 보여주는 작은 예제다. AnyBCQ 전체의 반복 최적화와 decoder block 복원까지 재현하는 것은 아니다.
① 원래 가중치에서 첫 부호와 스케일을 구한다
원래 가중치는 다음과 같다.
\[w=[3.2,1.4,0.9,0.7]^T.\]모두 양수이므로 첫 bit-plane은 $b_1=[+1,+1,+1,+1]^T$이다. 이 부호를 고정한 최소제곱 스케일은 절댓값의 평균이다.
\[\alpha_1=\frac{3.2+1.4+0.9+0.7}{4}=1.55.\]1비트 근사와 잔차는 다음과 같다.
\[\begin{aligned} \hat w^{(1)}&=[1.55,1.55,1.55,1.55]^T,\\ r^{(1)}&=w-\hat w^{(1)}=[1.65,-0.15,-0.65,-0.85]^T. \end{aligned}\]즉, 첫 번째 가중치는 더 크게, 나머지 세 가중치는 더 작게 만들어야 한다.
② 잔차로 두 번째 plane을 초기화한다
잔차의 부호를 두 번째 plane으로 사용한다.
\[b_2=[+1,-1,-1,-1]^T, \qquad \alpha_2=\frac{1.65+0.15+0.65+0.85}{4}=0.825.\]처음 스케일을 그대로 두고 새 항을 더하면
\[\hat w_{\mathrm{greedy}}^{(2)} =1.55b_1+0.825b_2 =[2.375,0.725,0.725,0.725]^T.\]비트는 늘었지만 $3.2$를 표현해야 하는 첫 원소가 아직 $2.375$에 머물러 있다. 처음에 구한 $1.55$는 1비트 근사에 맞는 스케일이지, 두 plane을 함께 사용할 때의 최적 스케일은 아니다.
③ 두 부호를 고정하고 스케일을 함께 다시 구한다
현재 부호 행렬은 다음과 같다.
\[B_2=[b_1\ b_2] =\begin{bmatrix} 1&1\\ 1&-1\\ 1&-1\\ 1&-1 \end{bmatrix}.\]이 행렬을 고정하고 $|w-B_2\alpha|_2^2$를 최소화한다. 최소제곱의 정규방정식은
\[\underbrace{\begin{bmatrix}4&-2\\-2&4\end{bmatrix}}_{B_2^TB_2} \begin{bmatrix}\alpha_1^{(2)}\\\alpha_2^{(2)}\end{bmatrix} = \underbrace{\begin{bmatrix}6.2\\0.2\end{bmatrix}}_{B_2^Tw}.\]이 예제에서는 더 간단하게 풀 수도 있다. 첫 원소는 $\alpha_1^{(2)}+\alpha_2^{(2)}$이고, 나머지 세 원소는 모두 $\alpha_1^{(2)}-\alpha_2^{(2)}$다. 따라서 첫 원소는 $3.2$, 나머지는 세 값의 평균 $1.0$으로 맞춘다.
\[\begin{aligned} \alpha_1^{(2)}+\alpha_2^{(2)}&=3.2,\\ \alpha_1^{(2)}-\alpha_2^{(2)}&=\frac{1.4+0.9+0.7}{3}=1.0. \end{aligned}\]두 식을 풀면
\[\boxed{\alpha_1^{(2)}=2.1,\qquad\alpha_2^{(2)}=1.1}\]이고, 최종 2비트 근사는 다음과 같다.
\[\hat w^{(2)}=2.1b_1+1.1b_2=[3.2,1.0,1.0,1.0]^T.\]스케일을 다시 구한 뒤의 codebook은 ${-3.2,-1.0,1.0,3.2}$다. 원래 가중치를 가장 가까운 값에 다시 배정해도 각각 $[3.2,1.0,1.0,1.0]$을 선택하므로, 이 예제의 2비트 부호는 더 바뀌지 않는다.
| 단계 | 스케일 | 잔차 제곱합 $|w-\hat w|_2^2$ |
|---|---|---|
| 1비트 | $1.55$ | $3.89$ |
| 두 번째 잔차 항만 추가 | $1.55,\ 0.825$ | $1.1675$ |
| 두 스케일을 함께 재최적화 | $2.1,\ 1.1$ | $0.26$ |
부호 비트는 그대로인데 스케일을 함께 조정하는 것만으로 오차가 더 줄었다. 이 차이를 이해해야 다음의 정밀도 확장을 이해할 수 있다.
④ AnyBCQ 방식으로 3비트로 확장하면 무엇을 고정하는가?
2비트 근사의 잔차는
\[r^{(2)}=w-\hat w^{(2)}=[0,0.4,-0.1,-0.3]^T.\]0의 부호를 $+1$로 정하면, 이 잔차를 보완하는 새 plane 후보는
\[b_3=[+1,+1,-1,-1]^T\]이다. 비교를 위해 기존 스케일을 고정하고 잔차에 대한 새 스케일만 구하면
\[\alpha_3=\frac{0+0.4+0.1+0.3}{4}=0.2\]가 된다. 이 경우
\[2.1b_1+1.1b_2+0.2b_3=[3.4,1.2,0.8,0.8]^T\]이고 잔차 제곱합은 $0.10$이다. 이는 기존 스케일을 유지한 채 새 잔차 항만 더하는 비교 방법이다.
AnyBCQ의 중요한 차이는 기존 부호 $b_1,b_2$를 유지하면서도, 3비트용 스케일 전체는 다시 맞춘다는 점이다. 위 $b_3$ 후보에 대해 다음 최소제곱 문제를 푼다.
\[\min_{\alpha^{(3)}}\left\|w-[b_1\ b_2\ b_3]\alpha^{(3)}\right\|_2^2.\]각 원소의 표현을 쓰면 다음과 같다.
\[\begin{aligned} \hat w_0&=\alpha_1^{(3)}+\alpha_2^{(3)}+\alpha_3^{(3)},\\ \hat w_1&=\alpha_1^{(3)}-\alpha_2^{(3)}+\alpha_3^{(3)},\\ \hat w_2=\hat w_3&=\alpha_1^{(3)}-\alpha_2^{(3)}-\alpha_3^{(3)}. \end{aligned}\]앞의 두 값은 각각 $3.2,1.4$에 맞추고, 같은 코드인 마지막 두 값은 평균 $(0.9+0.7)/2=0.8$에 맞춘다.
\[\begin{cases} \alpha_1^{(3)}+\alpha_2^{(3)}+\alpha_3^{(3)}=3.2,\\ \alpha_1^{(3)}-\alpha_2^{(3)}+\alpha_3^{(3)}=1.4,\\ \alpha_1^{(3)}-\alpha_2^{(3)}-\alpha_3^{(3)}=0.8. \end{cases}\]첫째 식에서 둘째 식을 빼면 $2\alpha_2^{(3)}=1.8$, 둘째 식에서 셋째 식을 빼면 $2\alpha_3^{(3)}=0.6$이다. 이를 대입하면
\[\boxed{\alpha_1^{(3)}=2.0,\quad\alpha_2^{(3)}=0.9,\quad\alpha_3^{(3)}=0.3}.\]최종 근사는 $[3.2,1.4,0.8,0.8]^T$, 잔차 제곱합은 $0.02$다. 기존 스케일까지 다시 맞춘 결과, 새 항만 더했을 때의 $0.10$보다 작아졌다.
| 실행 정밀도 | 사용하는 공유 plane | 해당 정밀도에 맞춘 스케일 | 잔차 제곱합 |
|---|---|---|---|
| 2비트 | $b_1,b_2$ | $2.1,\ 1.1$ | $0.26$ |
| 3비트 | $b_1,b_2,b_3$ | $2.0,\ 0.9,\ 0.3$ | $0.02$ |
3비트 모델의 마지막 plane만 빼고 스케일 $2.0,0.9$를 그대로 쓰면, 여기서 최적화한 2비트 모델과 달라진다. 2비트 실행에는 2비트용 스케일, 3비트 실행에는 3비트용 스케일을 선택해야 한다.
스케일을 최소제곱으로 갱신하는 것 자체는 일반 BCQ에도 사용된다. AnyBCQ의 차이는 이를 낮은 정밀도의 코드를 보존하는 확장 구조와 정밀도별 스케일에 연결한다는 것이다. 실제 알고리즘은 새 plane의 갱신과 스케일 최적화를 반복하고 calibration 기반 복원도 추가한다. 위 숫자는 그 구조를 한 번의 잔차 후보와 최소제곱 갱신으로 풀어 보여준 것이다.
⑤ 이제 현재 activation으로 LUT를 만든다
양자화는 위에서 준비했고, 추론 시 입력 activation이 다음과 같이 들어왔다고 하자.
\[x=[1,2,3,4]^T,\qquad\mu=4.\]부호 $-1$은 비트 0, $+1$은 비트 1로 바꾼다. 위치 $j=0$을 최하위 비트로 정하면
\[k=c_0+2c_1+4c_2+8c_3, \qquad T[k]=\sum_{j=0}^3(2c_j-1)x_j.\]한 가중치의 2비트·3비트 코드를 주소로 쓰는 것이 아니다. 같은 bit-plane에서 위치 4개의 부호를 모아 4비트 주소를 만든다.
| 주소 $k$ | 이진 주소 $c_3c_2c_1c_0$ | activation의 부호 있는 합 | $T[k]$ |
|---|---|---|---|
| 0 | 0000 |
$-1-2-3-4$ | $-10$ |
| 1 | 0001 |
$+1-2-3-4$ | $-8$ |
| 2 | 0010 |
$-1+2-3-4$ | $-6$ |
| 3 | 0011 |
$+1+2-3-4$ | $-4$ |
| 4 | 0100 |
$-1-2+3-4$ | $-4$ |
| 5 | 0101 |
$+1-2+3-4$ | $-2$ |
| 6 | 0110 |
$-1+2+3-4$ | $0$ |
| 7 | 0111 |
$+1+2+3-4$ | $2$ |
| 8 | 1000 |
$-1-2-3+4$ | $-2$ |
| 9 | 1001 |
$+1-2-3+4$ | $0$ |
| 10 | 1010 |
$-1+2-3+4$ | $2$ |
| 11 | 1011 |
$+1+2-3+4$ | $4$ |
| 12 | 1100 |
$-1-2+3+4$ | $4$ |
| 13 | 1101 |
$+1-2+3+4$ | $6$ |
| 14 | 1110 |
$-1+2+3+4$ | $8$ |
| 15 | 1111 |
$+1+2+3+4$ | $10$ |
현재 가중치의 plane은 $b_1=[+,+,+,+]$, $b_2=[+,-,-,-]$, $b_3=[+,+,-,-]$이므로 주소는 각각 15, 1, 3이다.
⑥ 최적화한 스케일을 적용해 최종 출력을 구한다
2비트 실행에서는 앞의 두 주소와 2비트용 스케일을 사용한다.
\[\begin{aligned} \hat y^{(2)} &=2.1T[15]+1.1T[1]\\ &=2.1\times10+1.1\times(-8)\\ &=\boxed{12.2}. \end{aligned}\]양자화 가중치를 직접 FP 값으로 복원해 계산해도
\[[3.2,1,1,1]x=3.2\times1+1\times2+1\times3+1\times4=12.2\]로 동일하다.
3비트 실행에서는 세 주소를 조회하고 3비트용 스케일을 사용한다.
\[\begin{aligned} \hat y^{(3)} &=2.0T[15]+0.9T[1]+0.3T[3]\\ &=2.0\times10+0.9\times(-8)+0.3\times(-4)\\ &=\boxed{11.6}. \end{aligned}\]직접 계산한 $[3.2,1.4,0.8,0.8]x=3.2+2.8+2.4+3.2=11.6$과 같다. 원래 가중치의 출력은
\[y=wx=3.2+2.8+2.7+2.8=\boxed{11.5}.\]이 입력에서는 2비트 출력 오차가 $0.7$, 3비트 출력 오차가 $0.1$이다. 이 차이는 가중치 양자화 오차다. 실수 연산 기준으로 LUT는 각 정밀도의 $\hat w^Tx$와 같은 계산을 수행한다. 다른 activation에서도 비트를 늘리면 개별 출력 오차가 반드시 줄어든다는 보장은 없으며, 출력 품질은 calibration과 실제 입력으로 확인해야 한다.
LUT 값에는 이미 activation과 부호의 내적이 들어 있다. 조회 후 activation을 또 곱하지 않는다. 조회한 부분 내적에 해당 정밀도의 스케일을 곱하고 합치면 선형 계층 출력이 된다.
⑦ 최적화 비용은 언제 내고, 추론 연산은 얼마나 줄어드는가?
지금까지의 과정을 수행 시점으로 나누면 다음과 같다.
| 시점 | 작업 |
|---|---|
| 양자화·배포 준비 | 잔차로 plane 초기화, 스케일 최적화, 정밀도 확장, 코드 packing, 정밀도별 스케일 저장 |
| 현재 입력의 추론 | Activation LUT 생성, 필요한 plane의 주소 조회, 해당 정밀도의 스케일 적용과 누적 |
즉, 새 토큰을 계산할 때마다 최소제곱으로 스케일을 다시 구하는 것이 아니다. 최적화한 코드와 스케일은 재사용하고, activation이 바뀔 때 LUT를 다시 만든다.
길이 4의 출력 행 하나를 직접 FP×FP로 계산하면 곱셈 4회와 덧셈 3회가 필요하다. LUT가 준비되어 있다면 2비트는 조회 2회·스케일 곱셈 2회·덧셈 1회, 3비트는 조회 3회·스케일 곱셈 3회·덧셈 2회로 계산한다.
출력 행이 하나뿐이면 LUT 생성이 오히려 부담이 될 수 있다. 이득은 같은 activation을 사용하는 많은 출력 행이 LUT 하나를 공유할 때 나타날 수 있다. 출력 행마다 부호와 스케일이 달라도 activation LUT는 공유할 수 있다.
출력 행이 $m$개라고 하자. 비교를 단순하게 하기 위해 LUT 16개 항목을 각각 3번의 덧셈·뺄셈으로 만드는 48회 생성 비용까지 포함한다. 실제 구현은 중간 합 재사용과 대칭성으로 이 비용을 줄일 수 있다.
| 항목 | 직접 FP×FP | 2비트 BCQ + LUT | 3비트 BCQ + LUT |
|---|---|---|---|
| LUT 생성 | 없음 | 입력당 덧셈·뺄셈 48회 | 입력당 덧셈·뺄셈 48회 |
| 곱셈 | $4m$회 | $2m$회 | $3m$회 |
| 출력 계산 덧셈 | $3m$회 | $m$회 | $2m$회 |
| LUT 조회 | 없음 | $2m$회 | $3m$회 |
예를 들어 $m=128$이면 다음과 같다. LUT 생성은 행마다 반복하지 않고 한 번만 수행한다.
| 방식 | 곱셈 | 생성 포함 덧셈·뺄셈 | LUT 조회 |
|---|---|---|---|
| 직접 FP×FP | 512회 | 384회 | 없음 |
| 2비트 BCQ + LUT | 256회 | 176회 | 256회 |
| 3비트 BCQ + LUT | 384회 | 304회 | 384회 |
2비트에서 3비트로 올리면 표현력이 늘어나는 대신 조회와 스케일 연산도 늘어난다. AnyBCQ는 같은 plane 집합을 공유하면서 이 정밀도별 비용·품질 선택을 가능하게 하고, LUT 방식은 선택한 plane의 계산을 조회와 누적으로 실행한다.
이 표는 연산 개수 비교이며 실측 속도는 아니다. FP 하드웨어는 FMA를 사용할 수 있고, LUT 방식에는 주소 추출·조회·데이터 이동 비용이 있다. 곱셈이 절반이라고 실행 시간도 절반은 아니다. 이 예제처럼 그룹이 작으면 스케일 저장 부담도 상대적으로 커지므로, 실제 구현에서는 그룹 크기와 LUT 재사용량을 함께 조정해야 한다.
결국 흐름은 원래 가중치 → 부호와 스케일 최적화 → 공유 코드를 유지한 정밀도 확장 → activation LUT 조회 → 정밀도별 스케일 적용 → 최종 출력이다. 정확도를 확보하는 일은 양자화 단계에서 수행하고, 추론에서는 그 구조를 이용해 가중치마다 반복하던 FP 곱셈을 줄인다.
3. 네 논문은 BCQ를 어떻게 사용했는가?
공통 표현을 이해했다면, 각 논문의 차이는 무엇을 최적화 대상으로 삼았는가로 정리할 수 있다.
| 논문 | 핵심 질문 | 주요 방법 |
|---|---|---|
| ShiftAddLLM | 스케일 곱셈까지 줄이면서 모델 정확도를 유지할 수 있는가? | BCQ와 additive power-of-two 스케일, 출력 복원, 혼합 비트 할당 |
| AnyBCQ | 하나의 코드 집합으로 여러 정밀도를 지원할 수 있는가? | 공유 bit-plane의 점진적 확장과 정밀도별 스케일 최적화 |
| LUT-GEMM | BCQ를 GPU에서 실제로 빠르게 실행할 수 있는가? | Packed weight와 shared-memory LUT를 사용하는 커널 |
| FIGLUT | LUT 조회를 위한 하드웨어 자체를 바꾸면 어떤가? | FF 기반 LUT, 대칭성 활용, bit-serial 데이터 흐름 |
3.1. ShiftAddLLM: 스케일 연산까지 재구성하기
ShiftAddLLM은 사전 학습된 모델을 대상으로, 선형 계층의 곱셈을 줄이는 방향으로 가중치를 재매개변수화한다. BCQ의 이진 부호뿐 아니라 스케일을 어떤 수치 구조로 표현하는가까지 계산 방식과 연결한다.
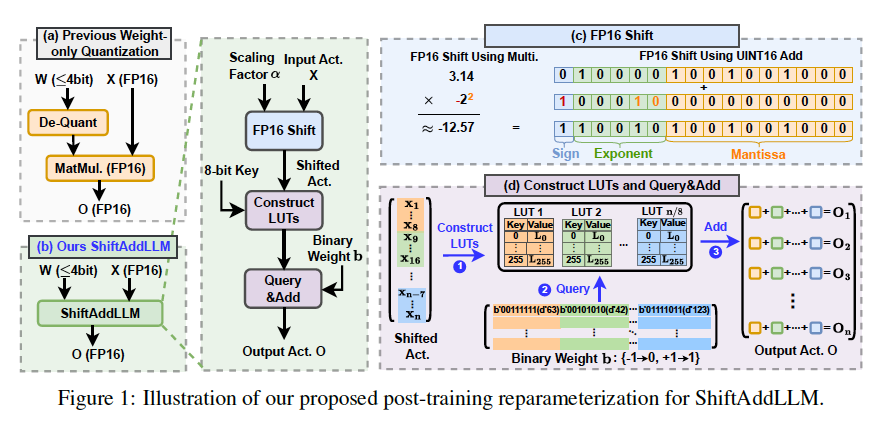 ShiftAddLLM의 Figure 1.
스케일을 2의 거듭제곱들의 합으로 표현한다
기본 BCQ에서도 스케일 곱셈은 남는다. ShiftAddLLM은 스케일을 다음과 같은 additive power-of-two 형태로 근사한다.
\[\alpha\approx\sum_{k=1}^{K}s_k2^{p_k}, \qquad s_k\in\{-1,+1\}.\]따라서
\[\alpha x\approx\sum_{k=1}^{K}s_k(2^{p_k}x)\]로 바꿀 수 있다. 예를 들어 $3.14$를 $4-1+0.125=3.125$로 근사하면, 일반 스케일 곱셈을 거듭제곱 배율 조정과 덧셈·뺄셈으로 분해한다.
스케일 하나를 거듭제곱 하나로만 제한하는 것보다 표현력이 높지만, 항 수 $K$가 늘면 연산도 늘어난다. 정확도를 위해 스케일을 복잡하게 만들수록 multiplication-less 계산의 이득이 줄어들 수 있다.
FP16에서 이 배율 조정은 부동소수점의 지수 구조와 관련된다. FP16 값을 정수처럼 통째로 비트 시프트하면 된다는 뜻은 아니다. 0, subnormal, overflow와 underflow 등은 별도로 고려해야 한다.
양자화 정확도와 계산 효율을 함께 맞춘다
스케일을 계산하기 쉬운 값으로 제한하면 원래 가중치를 맞추기 어려워질 수 있다. 이에 논문은 가중치 표현뿐 아니라 calibration activation을 통한 출력 복원과 오차 보상을 고려한다.
또한 스케일을 공유하는 단위가 세밀하면 정확도에 유리할 수 있지만, 계산을 묶어서 재사용하기는 어려워진다. 논문에서 정확도 중심 구성과 지연시간 중심 구성을 구분하는 이유도 이 절충에 있다.
모든 계층을 같은 비트 수로 처리하는 대신, 민감도에 따라 다른 비트 수를 배정하는 혼합 정밀도도 사용한다. 이는 특정 계층이 언제나 중요하다는 고정 규칙보다, 모델과 양자화 설정에 맞춰 자원을 배분하는 문제다.
ShiftAddLLM에서 BCQ는 스케일과 이진 부호를 분리해, 시프트·LUT 조회·누적 중심의 계산으로 바꾸는 출발점이다. 다만 대상 선형 연산의 재구성이 모델의 모든 연산에서 곱셈이 사라진다는 의미는 아니다.
3.2. AnyBCQ: 하나의 이진 코드로 여러 비트 수 지원하기
AnyBCQ는 서로 다른 정밀도의 모델을 효율적으로 제공하는 문제에 초점을 둔다. 2비트, 3비트, 4비트 모델을 각각 독립적으로 양자화하면 코드 자체가 달라질 수 있으므로, 단순히 4비트 모델의 일부 비트만 읽어서 더 낮은 정밀도로 사용하기 어렵다.
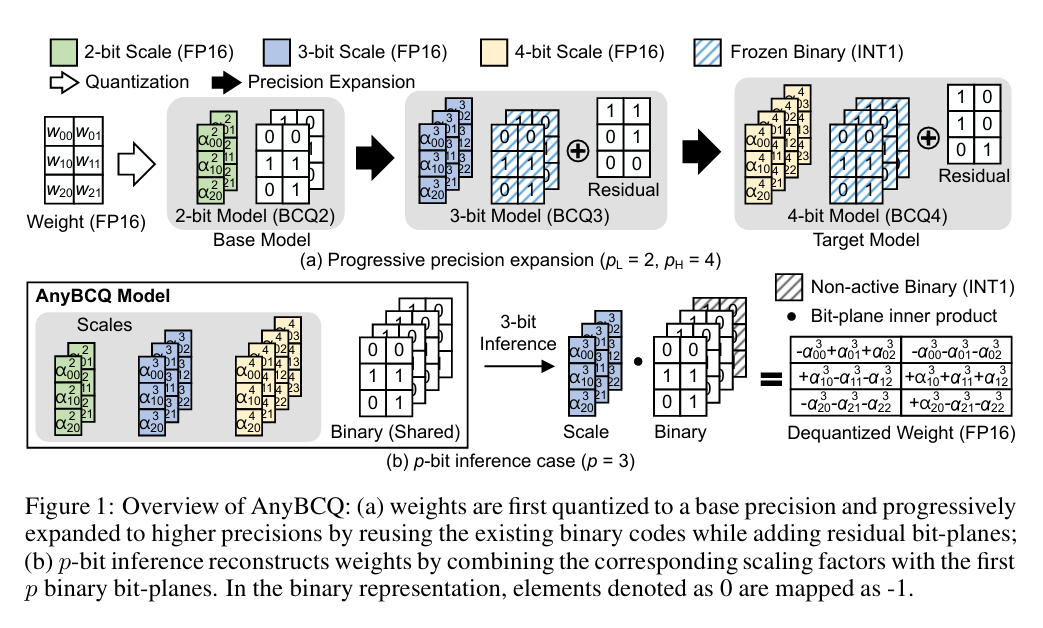 AnyBCQ의 Figure 1.
기존 bit-plane을 고정하고 새로운 plane을 추가한다
먼저 기본 정밀도의 BCQ 코드를 만든다. 이후 정밀도를 높일 때는 기존 부호를 유지하면서 새 bit-plane을 추가한다.
\[\begin{aligned} \hat w^{(2)}&=\alpha_1^{(2)}b_1+\alpha_2^{(2)}b_2,\\ \hat w^{(3)}&=\alpha_1^{(3)}b_1+\alpha_2^{(3)}b_2+\alpha_3^{(3)}b_3,\\ \hat w^{(4)}&=\alpha_1^{(4)}b_1+\alpha_2^{(4)}b_2+\alpha_3^{(4)}b_3+\alpha_4^{(4)}b_4. \end{aligned}\]공유되는 것은 $b_i$이고, 스케일은 정밀도별로 다르게 최적화한다. 2비트에서 가장 적절한 스케일이 4비트에서도 그대로 최적일 이유는 없기 때문이다.
확장 과정에서는 기존 plane을 고정한 상태로, 잔차에 맞춰 새 plane을 갱신하고 현재 정밀도의 스케일들을 다시 맞춘다. 새 부호를 한 번 구하고 끝내는 단순한 잔차 추가보다 더 정교한 최적화다. 이후 calibration 데이터를 이용한 decoder block 복원에서 스케일을 추가 조정한다.
이처럼 post-training 방식도 최적화 과정을 포함할 수 있다. PTQ라는 말이 모든 파라미터를 한 번의 수식으로 정하고 끝낸다는 뜻은 아니다.
실제 실행에서도 필요한 plane만 읽어야 한다
4비트까지 지원하는 모델을 저장하더라도 2비트로 실행할 때는 앞의 두 plane과 2비트용 스케일만 사용한다. 높은 정밀도의 데이터를 모두 읽은 다음 버리는 구현이라면 공유 구조의 메모리 이점이 충분히 살아나지 않는다.
이 구조는 계층마다 다른 정밀도를 배정하는 데도 활용할 수 있다. 다만 계층별 비트 할당과 여러 실행 정밀도를 위한 코드 공유는 서로 다른 개념이다. 전자는 어느 계층에 자원을 줄지의 문제이고, 후자는 여러 정밀도를 어떻게 함께 저장하고 사용할지의 문제다.
AnyBCQ에서 BCQ는 정밀도를 bit-plane 단위로 확장할 수 있는 표현이다. 독립적으로 최적화한 각 정밀도와 비교하면 코드 공유가 제약이 되므로, 저장 효율과 정밀도별 정확도 사이에 절충이 존재한다.
3.3. LUT-GEMM: GPU에서 복원 없이 계산하기
LUT-GEMM은 BCQ 형태의 계산을 GPU 커널로 연결한다. 핵심은 저비트 가중치를 FP 값으로 복원해 개별 곱셈을 수행하는 대신, 가중치 코드를 activation 부분합을 읽는 주소로 사용한다는 것이다.
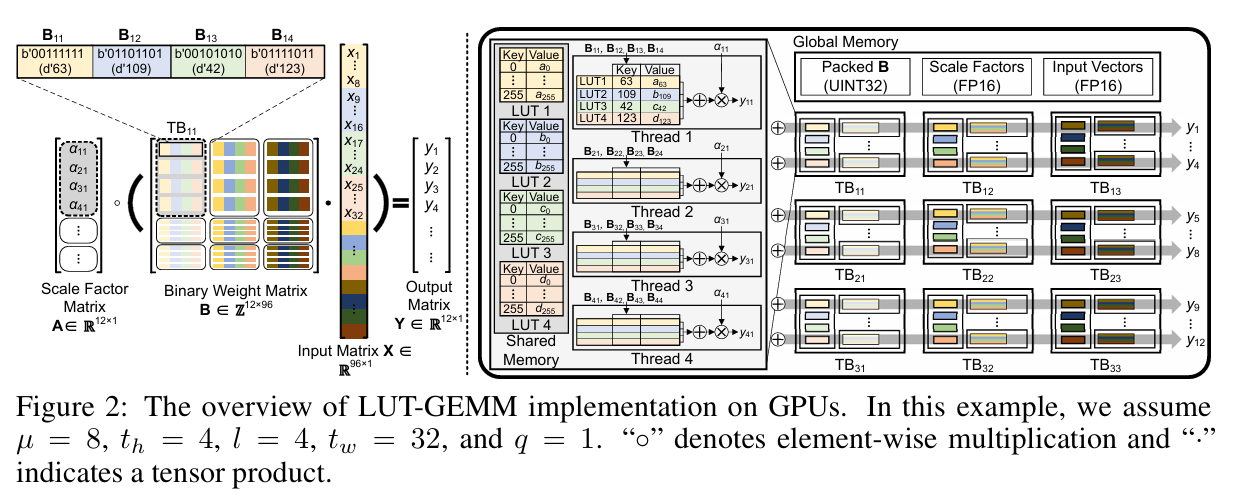 LUT-GEMM의 Figure 2.
Packed weight, LUT 생성, 조회, 스케일 적용을 연결한다
실행 흐름은 다음과 같다.
- 이진 가중치를 packed 형식으로 읽는다.
- 현재 activation 부분 벡터의 가능한 부호 합을 LUT에 만든다.
- 여러 출력 행의 가중치 코드로 같은 LUT를 조회한다.
- 부분합을 누적하고 해당 스케일과 offset 보정을 적용한다.
Packed word가 32비트여도 가중치 하나가 32비트라는 의미는 아니다. 여러 가중치의 부호 비트를 한 워드에 담아 읽는 저장 방식이다.
또한 LUT를 shared memory에 두는 것만으로 성능이 보장되지는 않는다. 블록마다 얼마나 많은 출력 행이 LUT를 공유하는지, 테이블 크기가 얼마나 되는지, 각 스레드의 작업량과 GPU의 병렬 실행 여유가 어떤지가 함께 영향을 준다.
재사용을 늘리면 자원 사용량도 늘어난다
큰 타일은 LUT 생성 비용을 더 많은 출력에 분산할 수 있다. 반면 레지스터나 shared memory 사용량이 커지면 동시에 실행할 블록 수가 줄 수 있다. 작은 타일은 병렬성을 확보하기 쉽지만 LUT 생성이 중복될 수 있다.
따라서 적절한 설정은 행렬 크기와 GPU 자원에 따라 달라진다. LUT 방식이 유리한 작은 배치의 실행 조건을, 큰 배치나 prefill까지 동일한 비율로 일반화해서는 안 된다.
Offset을 포함한 BCQ 표현을 사용하면 비균일 BCQ뿐 아니라 uniform quantization도 같은 계산 구조로 연결할 수 있다. 여기서 스케일 곱셈과 보정은 여전히 존재한다.
LUT-GEMM에서 BCQ는 저비트 가중치 형식과 GPU의 조회·누적 연산을 연결하는 인터페이스다. 양자화 오차를 낮추는 알고리즘만으로는 얻을 수 없는, 커널 수준의 최적화를 담당한다.
3.4. FIGLUT: LUT에 맞는 하드웨어 만들기
FIGLUT은 LUT 기반 계산을 전용 가속기로 구현한다. LUT-GEMM이 기존 GPU의 메모리와 실행 구조 안에서 최적화한다면, FIGLUT은 여러 연산기가 동시에 LUT를 읽는 구조 자체를 설계한다.
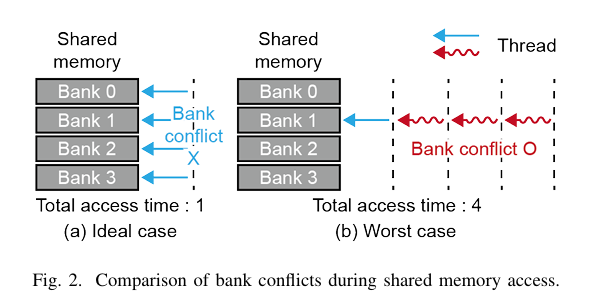 FIGLUT의 Figure 2.
불규칙한 조회의 비용을 줄인다
LUT 주소는 가중치 비트 패턴에 의해 결정된다. 여러 스레드가 서로 다른 주소를 읽는데 그 주소들이 같은 memory bank에 몰리면, 요청이 한 번에 처리되지 못할 수 있다. 같은 주소를 읽는 경우의 broadcast와는 구분해야 한다.
FIGLUT은 flip-flop과 선택 회로를 이용한 LUT 구조로 다수의 조회를 지원한다. 연산의 중심도 개별 곱셈과 누적보다 조회와 누적에 맞춘다.
이는 메모리 bank 제약을 줄이는 대신 회로 면적, 배선, fan-out 등의 비용을 발생시킨다. FF 기반 LUT가 어떤 크기에서나 SRAM보다 좋은 것은 아니며, 작은 테이블을 충분히 재사용할 수 있는 설계 조건이 중요하다.
부호 대칭성을 이용하면 저장 항목을 절반으로 줄일 수 있다
BCQ의 부호 있는 합에는 다음 대칭성이 있다.
\[T[\operatorname{complement}(k)]=-T[k].\]모든 부호를 반대로 바꾸면 합의 부호만 반전된다. 따라서 가능한 합 중 절반만 저장하고, 나머지는 조회 결과의 부호를 바꿔 얻을 수 있다. FIGLUT의 half-table 구조는 이 성질을 활용한다.
예를 들어 $\mu=4$이면 논리적으로 16개 합이 필요하지만, 대칭성을 이용하면 8개 값만 저장할 수 있다.
구현에서 주의할 점은 주소의 한 비트를 단순히 버리면 안 된다는 것이다. 저장하지 않은 절반에 해당하는 코드는 전체 부호 패턴을 반전한 대표 코드로 변환해야 한다. 이후 대표 코드의 값을 읽고 부호를 뒤집는다.
LUT 생성과 조회·누적의 흐름을 함께 설계한다
부분합 생성은 공통 중간 결과를 재사용하도록 구성하고, packed weight의 bit-plane을 처리하는 데이터 흐름과 결합한다. 스케일 처리도 별도로 연결해야 한다.
여기서 ‘곱셈을 LUT로 대체했다’는 말은 주로 반복되는 가중치·activation 곱의 처리 방식에 해당한다. ShiftAddLLM처럼 스케일까지 거듭제곱 합으로 바꾸는 접근과는 다르다.
FIGLUT에서 BCQ는 LUT의 부호 대칭성과 bit-serial 처리를 활용할 수 있게 하는 수학적 구조다. 이 구조를 바탕으로 메모리 조회, 테이블 생성, 누적의 비용을 하드웨어 수준에서 맞춘다.
4. 최종 정리: 장점, 한계, 앞으로의 방향
4.1. BCQ의 장점은 표현과 계산을 연결한다는 데 있다
BCQ의 첫 번째 장점은 압축된 코드가 계산에도 직접 사용된다는 점이다. 부호 비트는 작은 저장 단위인 동시에, activation을 더하거나 뺄 패턴을 지정한다.
두 번째는 스케일을 통해 양자화 분포를 조정할 수 있다는 점이다. 단순한 고정 간격보다 유연한 값을 만들면서도, 부호 합이라는 규칙적인 구조를 유지한다.
세 번째는 bit-plane 단위로 정밀도를 다룰 수 있다는 점이다. AnyBCQ처럼 추가 제약과 최적화를 설계하면 여러 정밀도의 코드 공유까지 가능하다. 단, 일반 BCQ를 독립적으로 학습했다고 해서 자동으로 이런 공유가 성립하는 것은 아니다.
마지막은 반복되는 계산을 재사용으로 바꿀 수 있다는 점이다. 같은 activation 부분 벡터에 대한 부호 합을 여러 출력에서 사용하는 경우, LUT 생성 비용을 많은 연산에 분산할 수 있다.
4.2. 한계는 정확도와 하드웨어 양쪽에 남아 있다
| 한계 | 이유 | 확인해야 할 항목 |
|---|---|---|
| 저비트 정확도 저하 | 제한된 부호 합으로 원래 분포를 표현해야 함 | 출력 복원 오차, perplexity, downstream 성능 |
| 최적화 제약 | 이산 코드와 연속 스케일의 결합, 공유 코드·스케일 형식의 추가 제약 | 초기화와 반복 최적화의 안정성 |
| 저장 overhead | 스케일, offset, 패딩도 저장해야 함 | 명목 비트 수가 아닌 실제 모델 바이트 수 |
| LUT 생성 비용 | Activation이 바뀔 때 테이블을 다시 만들어야 함 | 재사용 횟수와 생성 비용의 비율 |
| 메모리·회로 비용 | 테이블 크기와 동시 조회량이 커질수록 자원 소모가 증가 | Bank conflict, occupancy 또는 면적·전력 |
| 수치 오차 | 합산 순서와 중간값 정밀도가 바뀜 | LUT 결과와 기준 계산의 오차 |
| 적용 범위 | 모든 계층과 실행 단계의 병목이 같지 않음 | Prefill·decode·배치별 실제 지연시간 |
특히 수학적으로 같은 식이어도 부동소수점에서는 연산 순서에 따라 결과가 달라질 수 있다. LUT 생성 시의 부분합과 이후 누적에 어떤 정밀도를 사용할지도 정확도와 비용의 일부다.
또한 부분 커널이 빨라졌다고 전체 모델이 같은 비율로 빨라지는 것은 아니다. Attention, KV cache 접근, 다른 연산과 커널 실행 비용이 남아 있다. 전용 하드웨어의 결과와 GPU 커널의 결과도 실행 조건을 맞추지 않고 직접 비교하기 어렵다.
4.3. 앞으로는 비트 수 하나보다 전체 실행 조건을 최적화해야 한다
다음은 네 논문을 함께 읽고 도출한 방향이다. 각 논문이 이미 이 조합을 모두 구현했다는 의미는 아니다.
① $q$, $g$, $\mu$를 함께 선택해야 한다.
비트 수를 줄이면 코드량은 감소하지만 스케일 overhead나 LUT 생성 비용이 상대적으로 커질 수 있다. 그룹 크기와 LUT 부분 벡터 길이, 타일 내 재사용량까지 묶어서 실제 저장량·지연시간·정확도를 기준으로 선택할 필요가 있다.
혼합 정밀도의 ‘평균 비트 수’도 계층 비트 수의 단순 평균보다 파라미터 수로 가중한 값과 실제 저장 바이트를 함께 보는 것이 적절하다.
② Prefill과 decode에 같은 커널을 고집할 필요는 없다.
작은 배치에서 유리한 LUT 경로가 큰 행렬 연산에서도 가장 빠르다고 보장할 수 없다. 행렬 크기와 배치에 따라 LUT 기반 경로와 기존 고성능 행렬곱 경로를 선택하는 방식이 현실적인 발전 방향이다.
③ 공유 코드, 계산하기 쉬운 스케일, 전용 LUT 구조를 결합할 여지가 있다.
AnyBCQ의 공유 코드에 ShiftAddLLM의 스케일 제약을 적용하고, 이를 FIGLUT과 같은 구조에서 실행하는 조합을 생각할 수 있다. 그러나 제약을 동시에 추가하면 표현력과 최적화 난도가 달라진다. 각각의 이점을 단순히 더할 수 있다고 가정하지 말고, 정확도와 하드웨어 비용을 다시 측정해야 한다.
④ Calibration과 실제 사용 조건의 차이를 검증해야 한다.
출력 복원이 calibration 데이터에 맞춰져 있다면 다른 입력 분포나 긴 문맥에서도 품질을 유지하는지 확인해야 한다. 가중치 오차만으로 모델 품질을 판단하거나 하나의 지표만으로 안전한 비트 수를 정하기는 어렵다.
4.4. 네 논문을 하나의 흐름으로 이해하기
BCQ는 가중치를 부호 코드와 스케일로 분해하는 표현이다. 여기서부터 각 논문은 다른 질문을 이어 간다.
- ShiftAddLLM: 스케일까지 계산하기 쉬운 형식으로 바꿀 수 있는가?
- AnyBCQ: 여러 정밀도가 같은 코드를 공유하도록 만들 수 있는가?
- LUT-GEMM: 이 표현을 기존 GPU에서 빠르게 실행할 수 있는가?
- FIGLUT: 이 실행 방식에 맞는 하드웨어를 만들면 어떤 이점이 있는가?
따라서 BCQ의 성능을 평가할 때는 ‘몇 비트로 양자화했는가’에서 끝나면 안 된다. 어떤 스케일과 코드로 정확도를 유지했는지, LUT를 얼마나 재사용하는지, 최종 실행 장치에서 무엇이 병목으로 남는지까지 연결해서 보아야 한다.
참고 논문
이 글은 제공된 네 논문 정리 자료의 반복 내용을 통합하고, 공통 알고리즘과 논문별 기여를 구분해 재구성했다.
- ShiftAddLLM: Accelerating Pretrained LLMs via Post-Training Multiplication-Less Reparameterization, NeurIPS 2024.
- AnyBCQ: Hardware-Efficient Flexible Binary-Coded Quantization for Multi-Precision LLMs, ICLR 2026.
- LUT-GEMM: Quantized Matrix Multiplication based on LUTs for Efficient Inference in Large-Scale Generative Language Models, ICLR 2024.
- FIGLUT: An Energy-Efficient Accelerator Design for FP-INT GEMM Using Look-Up Tables, HPCA 2025.
Comments
로그인 없이 댓글을 남길 수 있습니다. 닉네임이나 @인스타아이디를 자유롭게 적어주세요.
댓글 창을 불러오는 중입니다…