ML - Lecture 17: Neural Networks part1
이제 그 유명한 neural network에 대해 다루어 볼 것이다. 이번 장에서의 목표는 classifier를 좀더 복잡하고 non-linear한 feature를 사용하는 것이다. Linear한 model은 만들기가 쉽지만 실제로는 잘 적용이 안된다는 단점이 있다. 그래서 polinominal한 feature를 사용할 수 있어야 한다. 그래서 예전에는 이 feature를 어떻게 설정을 할 건지가 model의 성능을 결정하였다. 이것을 feature engineering이라고 했고 사람이 했던 일이다. 그런데 neural network을 이용하면 이 feature를 자동적으로 뽑아낼 수 있다. 그래서 neural engine이 지금 그렇게 각광받고 있는 것이다.
◼︎ Single-layer neural network
일단은 층이 하나인 것부터 볼것이다. 그래서 여기서 perceptron이란것이 등장하게 된다.
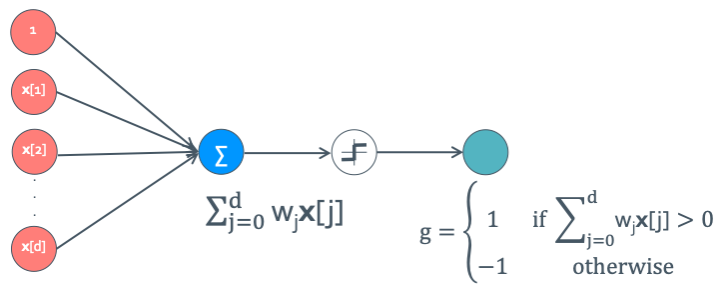
다음과 같이 생겼다. 여기에서 g를 어떻게 설정하느냐에 따라 다른 모델이 될 수 있다.
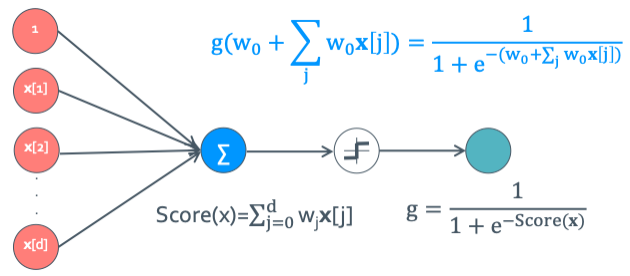
이렇게 g가 sigmoid function을 사용해서 sigmoid neuron이라고 한다.
이렇게 구한 식에서 sqaured error를 구할 것이다.
$z_i=w_0+\sum_jw_jx_i[j]$라고 쓰면 제곱오차와 gradient는
\[\begin{aligned} \ell(\mathbf w)&=\frac12\sum_i[y_i-g(z_i)]^2,\\ \frac{\partial\ell}{\partial w_j} &=-\sum_i[y_i-g(z_i)]\frac{\partial g(z_i)}{\partial w_j}\\ &=-\sum_i[y_i-g(z_i)]\,x_i[j]g'(z_i). \end{aligned}\]연쇄법칙에서 $\partial z_i/\partial w_j=x_i[j]$가 나오는 것이다. 절편 $w_0$의 경우 그 인자는 1이다.
이런 식으로 해서 perceptron의 개념을 통해 여러 function을 만들어 낼 수 있다.
◼︎ Hidden layer
여러 function을 만들 수 있다고 했는데 machine learning을 처음 배울 때 perceptron이 나온건 오래됐나 안썼다는 이유가 있는데 이게 특정 classifier를 만들지 못해서였다. 바로 XOR 논리 연산을 만들 방법이 없었다. 왜냐하면 XOR = X[1] AND NOT X[2] OR NOT X[1] AND X[2]과 같은 방식으로 만들어야 했기 때문이다. 하나의 layer로 만들기가 불가능 했다. 그런데 hidden layer라는 것을 통해 layer를 여러개 쓰면 이것을 해결할 수 있다는 아이디어가 나오게 됐다.
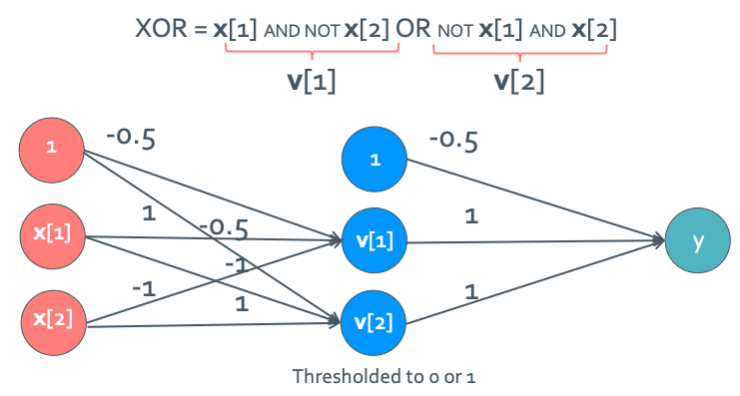
이렇게 hidden layer를 통해 더 많은 function들을 구현할 수 있게 되었고 non-linear한 function을 사용할 수 있게 됐다.
◼︎ Learning neural networks with hidden layers
근데 일단 hidden layer를 넣으면 점점 out(x)함수가 복잡해진다는 것이 문제였다.
원본의 입력→은닉 가중치는 $w_j^k$, 은닉→출력 가중치는 $w_k$다. 중간값을 이름 붙여 쓰면
\[\begin{aligned} a_{ik}&=\sum_jw_j^kx_i[j],& v_i[k]&=g(a_{ik}),\\ b_i&=\sum_kw_kv_i[k],& \operatorname{out}(\mathbf x_i)&=g(b_i),\\ \ell&=\frac12\sum_i[y_i-\operatorname{out}(\mathbf x_i)]^2. \end{aligned}\]출력층: 단일 노드와 같지만, 입력으로 은닉층 출력 $v_i[k]$를 사용한다.
\[\frac{\partial\operatorname{out}(\mathbf x_i)}{\partial w_k}=g'(b_i)v_i[k], \qquad \frac{\partial\ell}{\partial w_k} =-\sum_i[y_i-\operatorname{out}(\mathbf x_i)]g'(b_i)v_i[k].\]은닉층: 출력층에서 전달된 미분에 해당 노드의 미분을 곱한다.
\[\frac{d}{dx}f(g(x))=f'(g(x))g'(x), \qquad \frac{\partial\operatorname{out}(\mathbf x_i)}{\partial w_j^k} =\underbrace{g'(b_i)w_k}_{\text{from output layer}}\underbrace{g'(a_{ik})x_i[j]}_{\text{hidden node}}.\] \[\boxed{\frac{\partial\ell}{\partial w_j^k} =-\sum_i[y_i-\operatorname{out}(\mathbf x_i)]g'(b_i)w_k g'(a_{ik})x_i[j]}.\]표기 정정: 원본 하단의 은닉층 미분에는 은닉→출력 가중치 $w_k$가 빠져 있다. $b_i=\sum_kw_kv_i[k]$를 미분하면 반드시 $w_k$가 곱해져야 하므로 이를 보완했다. 중간값 기호만 도입했으며 두 층의 계산 구조는 동일하다.
Multilayer neural networks(MLP. Deep learning)
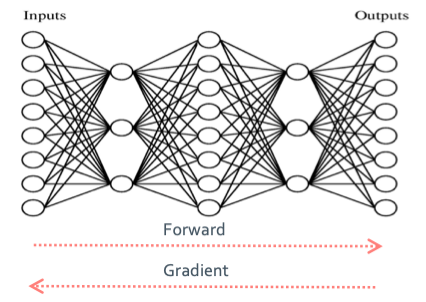
이제 이렇게 만든 net work system을 이용하는 방식에 대해 2가지로 나눠진다는 것을 보여줄 것이다.
- Forward propagation: 왼쪽에서 오른쪽으로 가는것으로 hidden layer를 하나하나씩 거쳐간다.
- Backward propagation(Gradient computation): 오른쪽에서 왼쪽으로 가는 것으로 node를 거쳐가는 것이다.
이 두 방향을 왔다갔다 하면서 learning을 하게 되는 것이다.
Comments
로그인 없이 댓글을 남길 수 있습니다.
댓글 창을 불러오는 중입니다…